
2026世界人工智能大会期间,由观察者网与WAIC CONNECT主办、半导体行业观察协办的“重构算力”产业链论坛在张江科学会堂举行。亿铸科技联合创始人兼总裁徐芳受邀发表主题演讲,首次正式发布“通用存算一体三大定律”,并系统阐释了亿铸科技全数字3D DRAM通用存算一体AI芯片的技术路线与产业价值,为后摩尔时代的AI算力演进提供了一套可参考的底层判断框架与落地方案。
存储墙困局:算力越强,有效释放越难
大模型产业正从参数竞赛转向场景落地,但传统冯·诺依曼架构下的“存储墙”已成为制约AI算力释放的核心瓶颈。数据传输与计算的耗时呈现约100:1的不平衡状态,大量时间消耗在数据传输通道上。
图灵奖得主约翰·轩尼诗曾指出,数据在存储与计算间搬运产生的能耗、延迟代价,可达单次计算本身的100倍;AI系统真正的性能瓶颈不在计算,而在数据搬运。徐芳在演讲中进一步分析,过去无论是GPU不断升级HBM,还是产业持续投入先进封装、高速互联,本质上仍停留在“优化搬运”阶段。“大家都在修路,而且把路修得越来越宽。但有没有一种可能,我们根本不用让数据跑这么远?”
三大定律:从搬运代价到异构终局
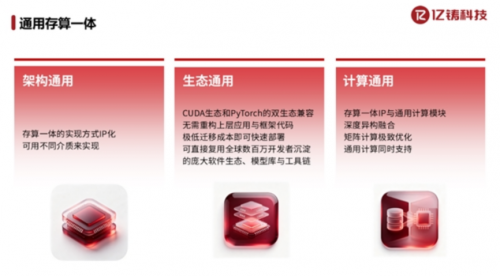
基于对产业规律的持续观察与实践总结,亿铸科技系统提出了通用存算一体的三大核心定律。
搬运代价定律:计算架构的每一次重大演进,归根结底都在回答同一个问题——怎样让数据搬运更高效。3D DRAM带来大容量基础,存算一体从架构上消除不必要的损耗,3D封装则提供高带宽互联,三者结合被视为当前破解AI数据搬运瓶颈的有效路径。徐芳进一步指出,随着大模型、多模态和Agent应用的普及,矩阵计算在整体计算中的占比已达90%至99%,数据搬运效率因此成为架构创新无法绕开的关键课题。
通用边界定律:专用计算单元在效率上的优势,常常会被通用计算所拥有的生态优势所抵消。只针对单一问题设计的技术,最终往往只能作为通用计算的补充,而难以成为主流平台。徐芳以Google为AlphaGo打造的TPU为例:TPU在专用场景中效率表现突出,但CUDA架构的GPU凭借更完善的软件生态和更强的通用性,最终成为更主流的选择。市场真正选择的,往往不是参数最极致的硬件,而是开发成本可控、生态丰富的通用方案。
异构终局定律指:单一计算单元很难同时做到“零搬运、全通用、高扩展”这三项要求。因此,存算一体的演进方向更可能是异构协同——通过架构层面的创新,带动系统整体效能的提升。也正因如此,架构设计能力正在成为通用存算领域一道重要的技术护城河。
技术落地:从理论到硬件的全链路验证
作为三大定律的落地实践者,亿铸科技已经把理论推进到了硬件层面:基于3D DRAM的全数字通用存算一体AI芯片成功流片,完成了从理论到硬件的全链路验证。
能效比方面,亿铸科技基于忆阻器打造的高精度、低功耗存算一体AI大算力POC芯片,已通过第三方机构验证,其能效比达到传统架构AI芯片平均水平的10倍以上。这意味着,国产大算力芯片即使不依赖最先进制程,也能通过架构创新实现能效比的显著提升。
全数字路线是亿铸科技区别于其他存算一体方案的关键所在。模拟存算一体在精度一致性上存在天然局限,而全数字方案在保证计算精度的前提下,通过存算一体IP与通用计算模块的异构融合,让芯片既能承担矩阵计算加速,也能独立完成完整的AI计算任务,而不是仅仅作为协处理器存在。
“存算一体如果仅能做矩阵乘法,更多会以GPU外设的形态存在;而走向通用计算平台,才能成为支撑下一代算力基础设施的重要力量。”徐芳在演讲中表示。亿铸科技大算力芯片以三大定律为判断框架,以经第三方验证的10倍能效比、3D DRAM技术路线和已流片的工程化成果,正在将这一判断转化为可部署的算力底座选择,为AI算力从“优化搬运”走向“消除搬运”提供了一条有据可依的架构创新路径。
免责声明:此文内容为广告,不代表本网的观点及立场。其内容由广告方提供,与本网无关,本文所涉文、图等资料之一切权力和法律责任归材料提供方所有和承担。本文仅供读者阅读并请自行核实内容真实性,网站对此资讯文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。